



2026/11/8 2:17:36
八个 GPT 账号一夜被封,研发工具链的三天迁移
八个 GPT 账号一夜被封,研发工具链的三天迁移
11 月 8 日早上,团队群里第一条消息是“你们能登上吗”。到九点半确认:我们八个付费账号,封了六个。三个个人订阅,两个 API 组织,一个绑了代码补全插件的账号。没有任何邮件通知,登录页只有一句账号已停用。
新闻稿后来才出来,说 OpenAI 这轮大规模封号是“无预警、无邮件”的。我们不是做模型的,只是用模型写代码的一个普通研发团队,但那天上午基本没干活。
这篇记一下我们三天怎么恢复的,以及哪些坑本来可以避开。
## 一、先摸家底:谁在用、用到哪一层
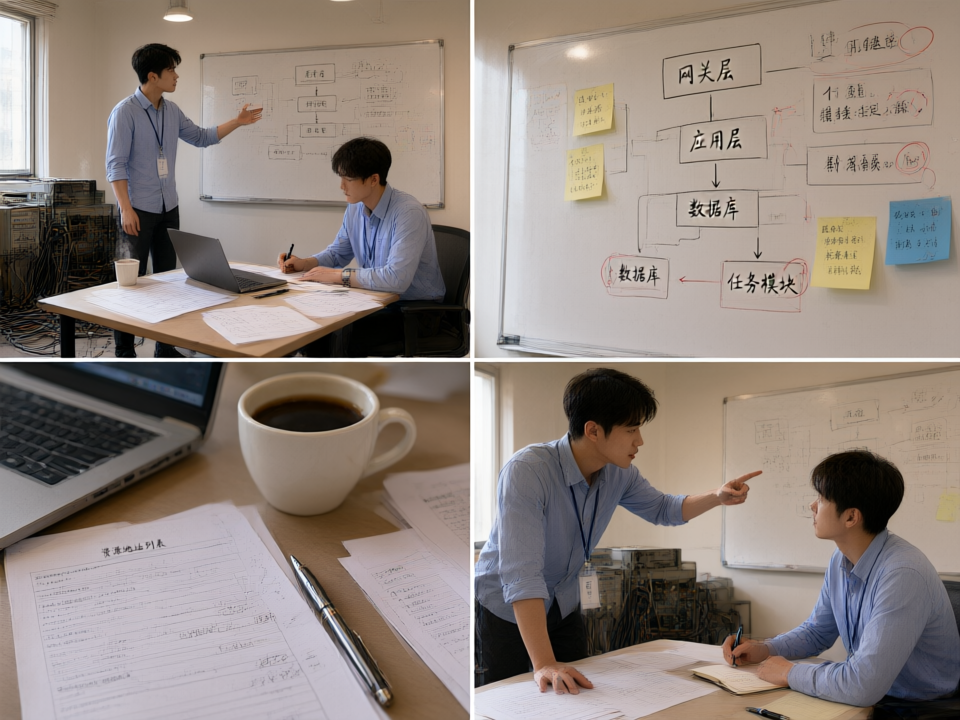
九点四十开紧急会,第一件事不是找替代品,而是列清单。列完才发现问题比封号严重:
- 六个后台服务里有四个直接引了厂商的 SDK,其中一个还把 key 写在了仓库的 `appsettings.json` 里;
- 三个同事的代码补全插件用的是个人账号,走的是公司采购流程,人走了账号就没人管;
- 客服知识库的 embedding 任务是定时跑的,用的 key 属于一个已经离职三个月的人。
后面这条最吓人。如果有人把那个 key 拿去刷量,账单还是公司付。
所以第一天先做两件止血的事:所有 key 全部轮换,仓库里硬编码的全部改为环境变量或密钥管理服务;再建一张账号资产表,记录用途、责任人、付费主体、到期时间。表不复杂,就是一个 Excel,但以前没人愿意做。
## 二、第二天:把调用收口到一个网关
业务代码直连厂商 SDK 是这次痛苦的根源。改的方式很土:自建一个 HTTP 网关,所有模型调用先打到这里。
网关干四件事:
1. 统一鉴权:业务侧只认内部 token,真正的厂商 key 不下发到任何服务;
2. 后端可切换:配置里写清楚哪个任务走哪家,改配置重启即可,不用重新发版;
3. 限流与计费:按项目打标签,哪个模块烧了多少 token 一清二楚;
4. 留痕:请求去敏后落一个月日志,出了问题能复现。
听起来像多此一举,但把“换模型”从一次发布变成一次配置修改,后面两天省了大量时间。
## 三、第三天:迁移,最麻烦的是 embedding
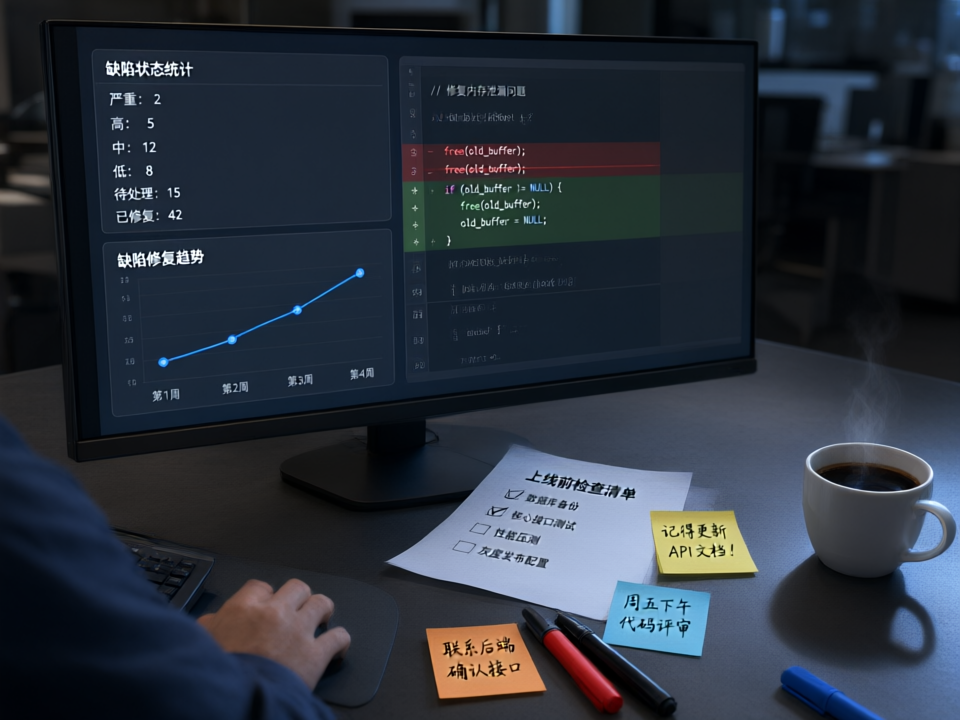
代码补全、文档生成、测试用例生成这三类换模型影响不大,提示词改改、输出格式加一层校验就能用。真正卡住的是向量检索。
原因是新模型的 embedding 维度跟原来不一样,向量库里的旧索引全部作废。我们的知识库有四十多万条切片,全量重算跑了六个小时,重算期间检索服务只能读旧索引,新写入的数据先排队。
如果当初建索引时把模型名和维度写进元数据,并且支持双索引并行,这次能少停半天。这是教训,写在这里。
另一个坑是输出格式。旧模型对 JSON schema 很听话,新模型偶尔会把字段名中文化,或者把数字变字符串。上线前加了一层 schema 校验加单次重试,不合法就回退到模板答案,看着笨但稳。
## 四、账号资产这件事,比模型选型重要
三天里最花时间的是填清单,不是调代码。做完之后我们定了五条规矩:
- 所有 AI 类账号一律用公司主体注册,不用个人邮箱;
- 至少两家供应商同时在用,不允许出现单点;
- key 不进代码仓库,密钥轮换周期三个月;
- 每个账号必须写责任人和用途,离职交接时自动带入清单;
- 月度账单导出一次,和实际项目用量对一遍。
这五条没有一条是技术难题,但可以避免下次再出现“人走了、key 还在、账单还在跑”。
## 五、代价与体会
说实话,换完之后体验是下降的。代码补全的准确率不如原来,某些长文档的归纳质量也一般。团队的应对办法是把 AI 用在“确定性高、可校验”的环节上,比如生成测试用例、生成模板代码、做接口文档初稿,而不是让它直接产出上线代码。
另外一个感受:把外部 AI 服务当成一个会随时消失的供应商来对待,比研究哪家模型分高更实用。模型分数每季度都在变,但账号被封、接口涨价、条款变更这些事,每年都会发生一次。
现在新项目立项,我会在架构评审里多问一句:如果明天这家服务不能用了,你的系统多久能切到备选?答不上来的,先别急着写业务代码。