



2026/11/13 2:17:46
代码扫描一万两千条告警,我们只修了三百条
代码扫描一万两千条告警,我们只修了三百条
11 月 12 日看到一条消息,说 Anthropic 那个自动找漏洞的计划被质疑:报了将近四万个候补漏洞,最后只修了两百多条。评论区很多人在骂“放着漏洞不修”,我看完的第一反应是:这太真实了,我们项目上就是这么干的,而且是有意为之。
去年给一家做政务系统的客户过等保测评,安服团队扔过来一份扫描报告,一万两千多条告警,红红绿绿一大片。客户领导在会上说“全部清零”。三个月后我们交付,修了三百多条,领导反而很满意。这篇讲讲这个数是怎么来的。
## 一、一万两千条里,真正该修的不到一成
先把报告拆开看:
- SAST 静态扫描大约七千条,其中命名不规范、没写异常处理、方法过长这类“代码味道”占了六成;
- 依赖组件漏洞(SCA)大约三千条,很多是同一条 CVE 在不同模块各报一次;
- 剩下的才是真正能被利用的:SQL 拼接、任意文件读取、未授权接口。
关键问题是,扫描器把它们全放在一个列表里,最高优先级同样标“严重”。如果按单子从上往下修,你会在两个星期里把时间花在改命名上。
## 二、第一件事:把“有漏洞”和“能被利用”分开
我们做了一次可达性分析。听起来高级,实际上很土:
- 对每个依赖漏洞,先查它对应的包有没有真的被调用,没调用的直接降级;
- 对有公开 PoC 且在调用链上的,直接提到最高优先级;
- 自定义代码的注入类问题,直接看参数是否来自外部输入,有过滤的降级。
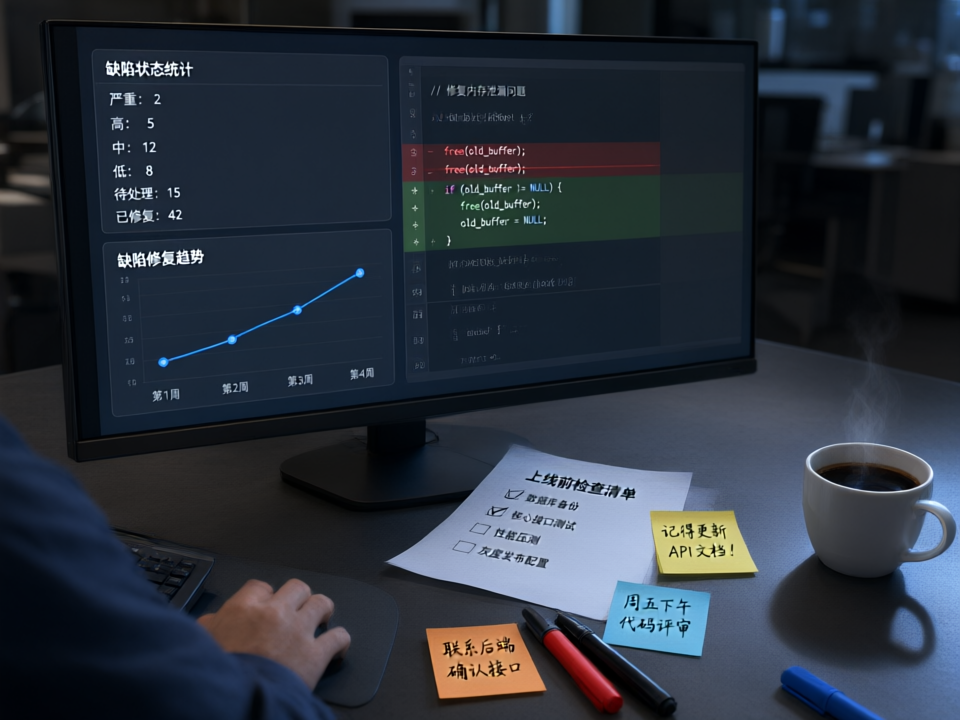
这一步花了一周,把一万两条压到了九百多条。剩下的三百多,才是我们真正动手改的。
## 三、第二件事:存量冻结,增量零容忍
全量清零不现实,因为存量代码是三年累积的,改一个可能带出三个回归。所以我们和客户达成了一个方案:
- 存量:建基线白名单,每条必须有责任人和期限,不允许“默认忽略”;
- 增量:新提交的代码进 CI 门禁,出现高危直接阻断合并,中低危只告警。
这条规则最有用。三个月里,存量没怎么降,但新代码没再引入新高危。总告警数从一万二降到六千多,主要是因为新代码不再叠加。
## 四、第三件事:分级 SLA,别一律“尽快”
我们定了三档:
- 高危(可利用、涉及敏感数据):七个工作日内修复,修不了就下线功能;
- 中危:随下个迭代修,允许排期;
- 低危:仅记录,季度评估一次。
定了日期之后,开发不再问“这个要不要修”,而是看级别。这件事的管理价值大于技术价值。
## 五、三个真实的例子
- 一条 Log4j 的传递依赖,扫描器报了十二次。实际查下来,只有一个服务引入了它,且日志参数固定。升级后消失。
- 一条“硬编码密码”高危,打开代码看是测试环境的假数据,`password = "123456"`,但它真的在仓库里。最后把测试配置从仓库里抽走。
- 一条 SQL 拼接,扫描器只给了中危。实际上那个接口的参数直接来自 URL,而且没登录。这条我们排到了第一优先级,比很多高危还早。
最后这条说明一个事:扫描器的分级不代表业务风险,得有人看。
## 六、代价
门禁上线的第一个月,开发怨声很大。原因很具体:
- 旧代码里引用的公共类被改了一下,连带触发一堆新告警,拦了别人的合并;
- 扫出来的问题有的确实是误报,但要走流程申请白名单,比直接改还慢;
- 白名单会腐化,一开始十几条,半年后三百多条,里面混着“先加上再说”的。
应对办法很土但管用:白名单每条必须写理由和到期日,到期没处理自动恢复告警;每两周拉一次会,把上两周挡住合并的条目逐条过。
## 七、结果
三个月后交付时的数:高危从 187 条降到 0,中危减少六成,新增代码的告警密度下降明显,等保测评顺利通过。
但我想说的不是“我们修得多快”,而是另一件事:安全治理的目标不是把报告清零,而是把风险变成可管理、有主人、有期限的清单。一万两千条无人负责的告警,还不如三百条有人盯着的。
## 最后
现在接带等保要求的项目,我会在报价里单独列一项“安全扫描治理”,而不是把它当成开发附带的活。这项工作不产生新功能,但能让验收少拖一个月。
客户后来问我一句话,我觉得挺准确:你们不是把漏洞修完了,是把该修的先修了。对,就是这样。