



2026/11/18 2:18:14
三十台机器上的应用日志,接成了一条可校验的哈希链
三十台机器上的应用日志,接成了一条可校验的哈希链
前阵子在开源中国上看到一个日志分析工具的宣传点,说它每条结论都带原文行号和 sha256。这句话看得我有点感慨——日志这东西被人当了二十年的调试附属品,现在终于开始被当成证据来对待了。
同一时间,我们手上一个政企服务平台正好做到等保复测。审计项里有一条很平静的要求:网络日志留存不少于六个月,审计记录应受到保护、避免意外删除、修改或覆盖。就这一条,我们补了三个月的课。
**原来的状态**
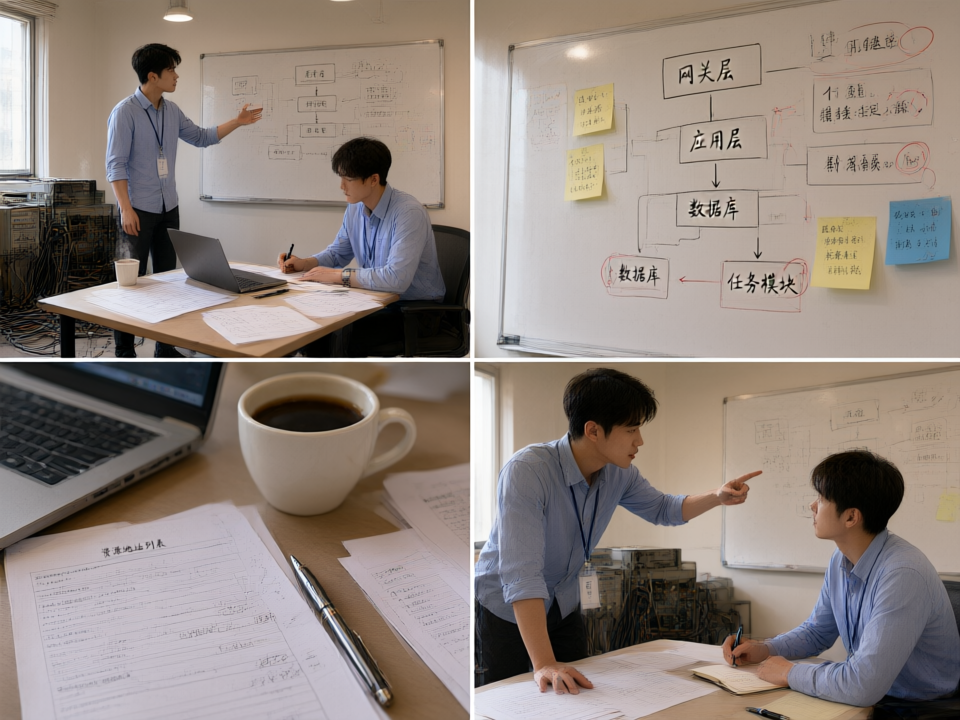
三十多台机器,包括应用服务器、网关、定时任务节点,日志各自写到本地文件,按天切割,保留八天。权限是统一的 root,出事时运维登录上去 grep,能找到算运气好,找不到就复原不了。
这个状态在很多定制项目里很常见。它不难用,但它三个条件都不满足:存不到六个月;任何人都能改;查一个越权操作要人工比对四五台机器的文件。
**第一件事:先把日志收走**
我们没动业务代码,先上了采集层。每台机器一个采集进程,读本地文件、加机器标识和采集序号、推到日志平台。保留策略分成两层:热数据存三十天,支持全文检索;冷数据转对象存储,保留两百天,只支持按 ID 和时间范围取回。
这里有个数字值得说:日志量从每天 12GB 涨到 90GB。不是因为加了日志,是因为原来滚掉的、从来没被看过的那些也一并留下了。最后我们在采集侧加了采样规则:调试级别的按 5% 采,业务关键链路全量,安全类事件一条不少。量降到 38GB,审计需要的都在。
**第二件事:把日志串成链**
这是整件事里唯一需要设计的地方。
做法不复杂:每条日志除了自身内容,还带上前一条日志的摘要值,形成一个单向链;每小时把该时段的最后一条摘要单独固化,写进只有追加权限的审计库,同时同步一份到对象存储的只写不删分区。
这样做的意义不是“防住所有人”。拥有足够权限的人依然可以删日志,但他删完之后,后续日志的链就对不上了,而段尾摘要是分开存的,他得同时改两处才能瞒过去。哈希链真正的价值,是把“有没有被改过”从一件靠信任的事,变成一件能验证的事。
**第三件事:让它能查、且不泄露**
日志收上来只是原材料。我们把每条业务日志的字段定成固定形制:traceId、操作人、操作对象、结果码、耗时,缺一个字段就不算合规日志。越权排查时按 traceId 一拉,能拿到一次请求在五个服务里的完整轨迹。
脱敏在采集侧做。身份证、手机号、银行卡在写入前就按规则替换,密钥和 token 直接整段丢弃。这一条当时有争议,业务方说排查时需要看真实手机号。我们的理由是:日志留存六个月,意味着敏感数据要在系统里多存六个月。真要核对,拿日志里的哈希去业务库比对就行,不用把明文写进日志。
**踩到的坑**
最大的坑是时钟。哈希链按时间排序,一旦某台机器的时间漂了几秒,链的顺序就乱了,校验会误报。后来改成每台机器各一条链,段尾摘要带机器标识和时间窗,跨机器用 traceId 关联。把一个全局单链拆成三十条局部链,反而稳了。
第二个坑是索引。最初把所有字段都建了索引,查询没快多少,存储先翻了倍。最后只给 traceId、操作人、结果码三个字段建索引,其他靠全文检索。
**结果**
等保复测的审计项一次过。更实际的变化在后面:上个月一次超管账号异常操作排查,从发现到定位到具体请求用了四十分钟,而以前同样的事我们要过两天。而且这次能给出一个明确结论——从出事到取证,相关时间段的日志链完整,没有被插入或删除过。
做了这么多年系统定制,我越来越觉得交付物里应该多一项:不只是功能跑得通,还包括出事时你能不能把现场原样地拿出来。日志哈希链这种改造,平时看不出来,出事那天很值钱。
广州市网景网络科技有限公司 现在的政企类项目,日志留存、采集脱敏、摘要链三项直接写进交付清单,不等审计提了再补。