



2026/11/15 2:18:09
音乐平台上线的 AI 生成标识,从元数据一直做到分享卡片
音乐平台上线的 AI 生成标识,从元数据一直做到分享卡片
11 月 14 日看到一篇报道,说单曲循环的那首歌可能是花三百元买的 AI 作品,它们正在挤进歌单。这个现象对我们做平台的不是新闻——我们的客户里有一家做独立音乐分发的,今年三月就发现上传量暴涨,其中相当一部分是 AI 生成。
真正麻烦的不是产量,是来源。平台上五万多首曲子,没人能说清楚哪些是人写的、哪些是模型生成的。五月开始做标识改造,一直做到八月。这篇记录一下。
## 一、先明确目标:不是“检测出来就下架”
一开始运营的想法很简单:查出来是 AI 生成的就限流。我没同意,理由有两个:
- 误判成本极高。一首人写的歌被判成 AI,创作者会直接离开,而且会在圈子里说;
- 合规要求不是“封”,是“标”。生成内容需要有可识别的来源信息,让人知道它是什么就够了。
所以目标定成三件事:能识别、标得准、改得掉(申诉能动)。
## 二、第一层:上传时的显式声明
最便宜也最有效的一层,是在上传页加一个必选项:创作方式(纯人工 / 含 AI 辅助 / AI 生成)。选“含 AI 辅助”的还要填使用了哪些环节(作曲、编曲、人声合成)。
配套两个约束:
- 声明会形成一条不可修改的记录,改声明要走审核,不能自己改;
- 声明“纯人工”但后续被检测命中高置信度,会触发复核,而不是自动判罚。
上线第一个月,只有 18% 的 AI 曲目主动声明的。剩下的是靠检测补的。
## 三、第二层:把来源写进文件
声明只存数据库不够,因为文件会被下载、转发、再上传。我们在两个地方写隐式信息:
- ID3 标签里的自定义字段,写入“生成方式、疑似模型、标识时间”;
- 文件的扩展元数据区,写入一个版权信息块(类似 C2PA 的思路,但我们只做了字段级)。
这一步有个很现实的坑:用户会把音频重新编码。一次转码,元数据就没了。所以我们没有把宝压在这上面——它只是“愿意保留的人能保留”,不是唯一的依据。
## 四、第三层:检测与置信度分档
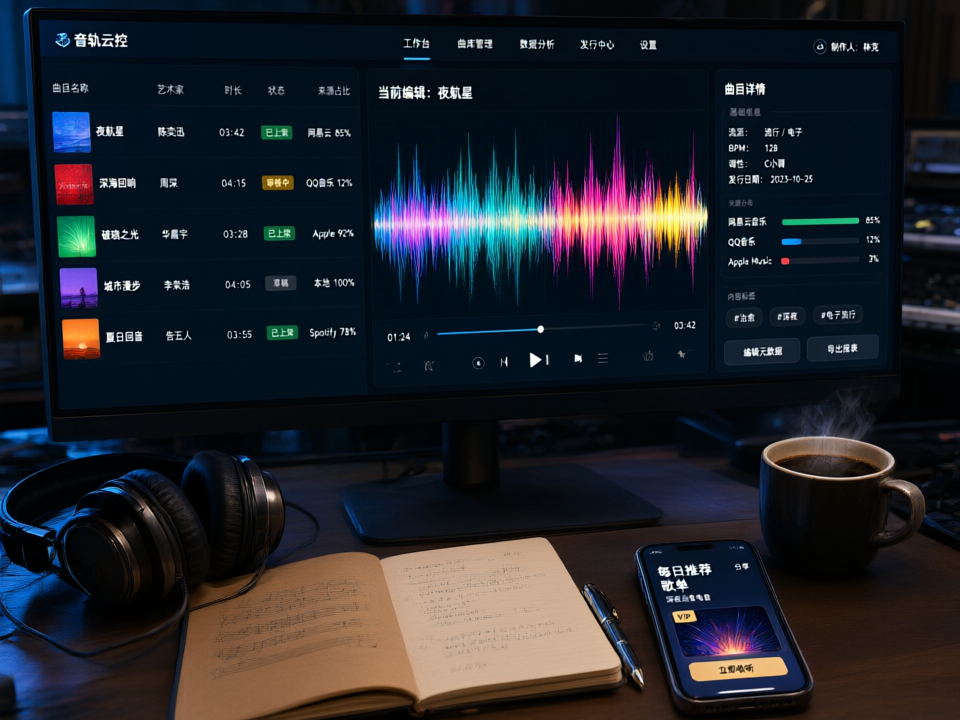
检测用了两种信号:音频指纹比对已知 AI 生成样本库,以及一个音频分类模型。两路结果合成一个分数,按分数分三档:
- 高于 0.85:自动打“AI 生成”标;
- 0.55 到 0.85:打“来源待核实”,人工复核,复核期间不影响分发;
- 低于 0.55:不打标,但入样本池。
为什么中间要有一档“待核实”?因为自动下结论一定会错,而错在创作者身上是不可逆的。宁可多一个中间态。
## 五、第四层:标识要跟到端上
这是最容易被漏掉的一层。数据库里有标识,不代表用户能看到。我们改了三处:
- 播放页曲目信息下方加角标,点击可以看“来源说明”;
- 分享卡片的右下角保留标识,不能因为卡片模板好看就去掉;
- 导出与开放接口返回的元数据里,带上标识字段。
最后一条踩过坑:一开始我们只改了 App,H5 和车载端没同步,结果同一首歌在不同端显示不一致,被用户截图发到社区质疑。后来把“标识字段”做进了统一的曲目 DTO,各端必须渲染。
## 六、最有争议的部分:申诉
上线后第二周,一批独立音乐人被误判,大多是用合成器音色多的作品。他们的投诉很具体:“你们凭什么说我是 AI”。
我们做了三件事:
- 申诉入口放在标识旁边,不藏在帮助中心;
- 申诉必须由人工处理,且给出具体理由,不允许模板回复;
- 申诉成功的作品会进入白名单,同时把它的指纹从“AI 样本库”里拉黑,避免重复误判。
一个月内申诉了 137 首,改判 41 首。这个误判率不算低,但因为没有直接限流,伤害可控。
## 七、代价
- 检测成本不低,每个月音频转码加推理的钱差不多是三个人工审核的工资;
- 人工复核一度成了瓶颈,后来把“待核实”的优先级按播放量排,先处理影响面大的;
- 老内容回溯很痛苦,五万首存量只能分批跑,到现在才扫了七成;
- 创作者有抵触情绪,觉得被当成嫌疑人。运营后来在公告里加了一句话:标识不是定性,是告知。这句挺有用。
## 八、结果
三个月后的数:AI 声明率从 18% 升到 63%,自动标识覆盖存量约七成,相关投诉从每周几十起降到个位数,因为用户终于能看懂一首歌是什么来路。
## 最后
做内容平台的技术人都得接受一个现实:你没办法把 AI 内容拦在门外,你只能把来源说清楚。标识的价值不在“管控”,而在让用户自己判断。
如果你们也要做这块,我的建议是先做“显式声明 + 中间态标签 + 申诉通道”这三样,成本最低,效果最直接。检测模型可以慢慢调,但别让它一个人拍板。